프로젝트 소개
Beluga는 개인 개발 환경에서 현대적인 데이터 플랫폼의 전체 흐름을 재현하기 위한 Kubernetes 기반 self-hosted data platform입니다.
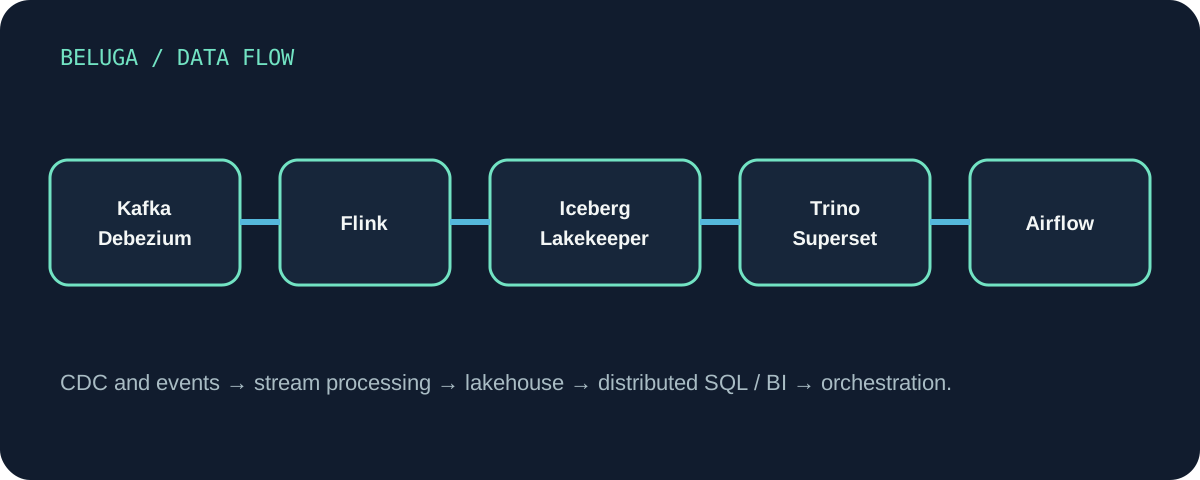
핵심은 개별 OSS를 모아 놓는 것이 아니라 다음과 같은 데이터 lifecycle을 하나의 재현 가능한 환경에서 검증하는 것입니다.
Beluga는 “프로덕션 규모 데이터 플랫폼”을 표방하지 않습니다. 로컬에서 데이터 플랫폼의 통합 동작, 권한 모델, storage/query 경계와 GitOps 운영 패턴을 실험하기 위한 개인/학습 스케일 reference platform입니다.
플랫폼 구성
| 영역 | 컴포넌트 | 역할 |
|---|---|---|
| Cluster | k3s + Cilium + MetalLB | 로컬 Kubernetes 실행 기반 |
| Gateway | APISIX + etcd | 플랫폼 UI 및 API entrypoint |
| GitOps | Argo CD | app-of-apps 기반 선언적 배포 |
| Identity | Keycloak + OpenLDAP | 인증 및 그룹 기반 접근 제어 |
| Policy | OPA + OpenFGA | 서비스 정책과 lakehouse 인가 |
| Streaming | Strimzi Kafka + Debezium | Event streaming / CDC |
| Processing | Flink Kubernetes Operator | Statefull stream processing |
| Catalog | Lakekeeper | Iceberg REST catalog |
| Storage | SeaweedFS | S3-compatible object storage |
| Database | CloudNativePG | PostgreSQL source / metadata DB |
| Query | Trino | Iceberg distributed SQL |
| BI | Superset | Interactive analytics / dashboards |
| Orchestration | Airflow 3 | compaction / aggregation DAG |
| Optional Governance | OpenMetadata + OpenSearch | metadata / lineage |
| Observability | Prometheus Stack | platform metrics |
핵심 설계 포인트
1. Kubernetes가 데이터 플랫폼의 공통 운영 경계
각 데이터 컴포넌트가 서로 다른 설치 방법을 사용하지 않도록 Helm과 Operator를 중심으로 Kubernetes 리소스에 맞춥니다. Beluga의 주요 차트는 beluga-platform과 beluga-data로 계층화되어 있습니다.
2. GitOps가 실제 deployment contract
Argo CD App-of-Apps를 통해 플랫폼과 데이터 레이어를 선언적으로 배포합니다. 따라서 “로컬에서 한 번 잘 동작했다”가 아니라 Git 상태와 실제 cluster 상태를 비교할 수 있습니다.
3. 데이터 경로를 두 개의 시나리오로 검증
- Clickstream demo — synthetic events → Kafka → Flink → Iceberg → Trino/Superset
- PostgreSQL CDC — PostgreSQL → Debezium → Kafka → Flink → Iceberg
이는 단순 chart install 성공보다 실제 데이터가 경계를 통과하는지를 검증합니다.
아키텍처
로컬 리소스 모델
Beluga는 VM 4대와 전체 데이터 스택을 함께 구동하므로 가벼운 demo가 아닙니다.
- 최소 호스트 RAM: 32GB
- 48GB 이상: OpenMetadata 및 Trino worker 등 확장 profile 사용 가능
- 64GB 이상: worker memory 추가 확장
- VMware Fusion(ARM64) 또는 VirtualBox(AMD64) 지원
- 실제 메모리 상황에 따라 profile을 자동 선택
따라서 Kube-Ready-Box처럼 “노드 baseline”을 제공하는 프로젝트와 달리 Beluga는 전체 data platform 통합 비용을 한 번에 보여주는 상위 reference environment입니다.
검증 구조
Beluga는 렌더링 성공과 실제 동작을 구분합니다.
각 단계는 “서비스가 설치되었는가”가 아니라 실제 API와 데이터 흐름이 기대한 상태인지 확인합니다.
보안 및 자격증명
Beluga는 repository에 비밀번호를 커밋하지 않고 bootstrap 시점에 credential을 생성합니다. Kubernetes Secret에 저장하고 Helm에는 값 자체가 아니라 필요한 참조만 넘기는 구조를 사용합니다.
또한 policies/를 별도 source of truth로 두어 Keycloak, Rego, PostgreSQL 권한 산출물 사이의 일관성을 관리하려는 방향을 취합니다.
현재 상태
Beluga는 개인/학습 스케일의 reference implementation입니다.
- 핵심 Kafka/CDC → Flink → Iceberg → Trino/Superset/Airflow 흐름은 clean-install E2E를 목표로 구현
- 라이브 클러스터가 항상 실행 중인 것은 아니므로 모든 최신 변경이 상시 live validation되는 것은 아님
- 정책 컴파일러 통합과 거버넌스 영역은 별도 범위로 계속 진화
시작하기
git clone https://github.com/dasomel/beluga.git
cd beluga
make up
make status
make test상세 기술 문서
| 주제 | 문서 | 내용 |
|---|---|---|
| Overview | 플랫폼 개요 | 문제 정의와 제품 범위 |
| Architecture | 아키텍처 | 전체 데이터 흐름과 컴포넌트 경계 |
| Getting Started | 설치 가이드 | VM → k3s → GitOps bootstrap |
| Operations | 운영 가이드 | 상태, upgrade, data lifecycle |
| Troubleshooting | 문제 해결 | cluster, Kafka, Flink, query 장애 |